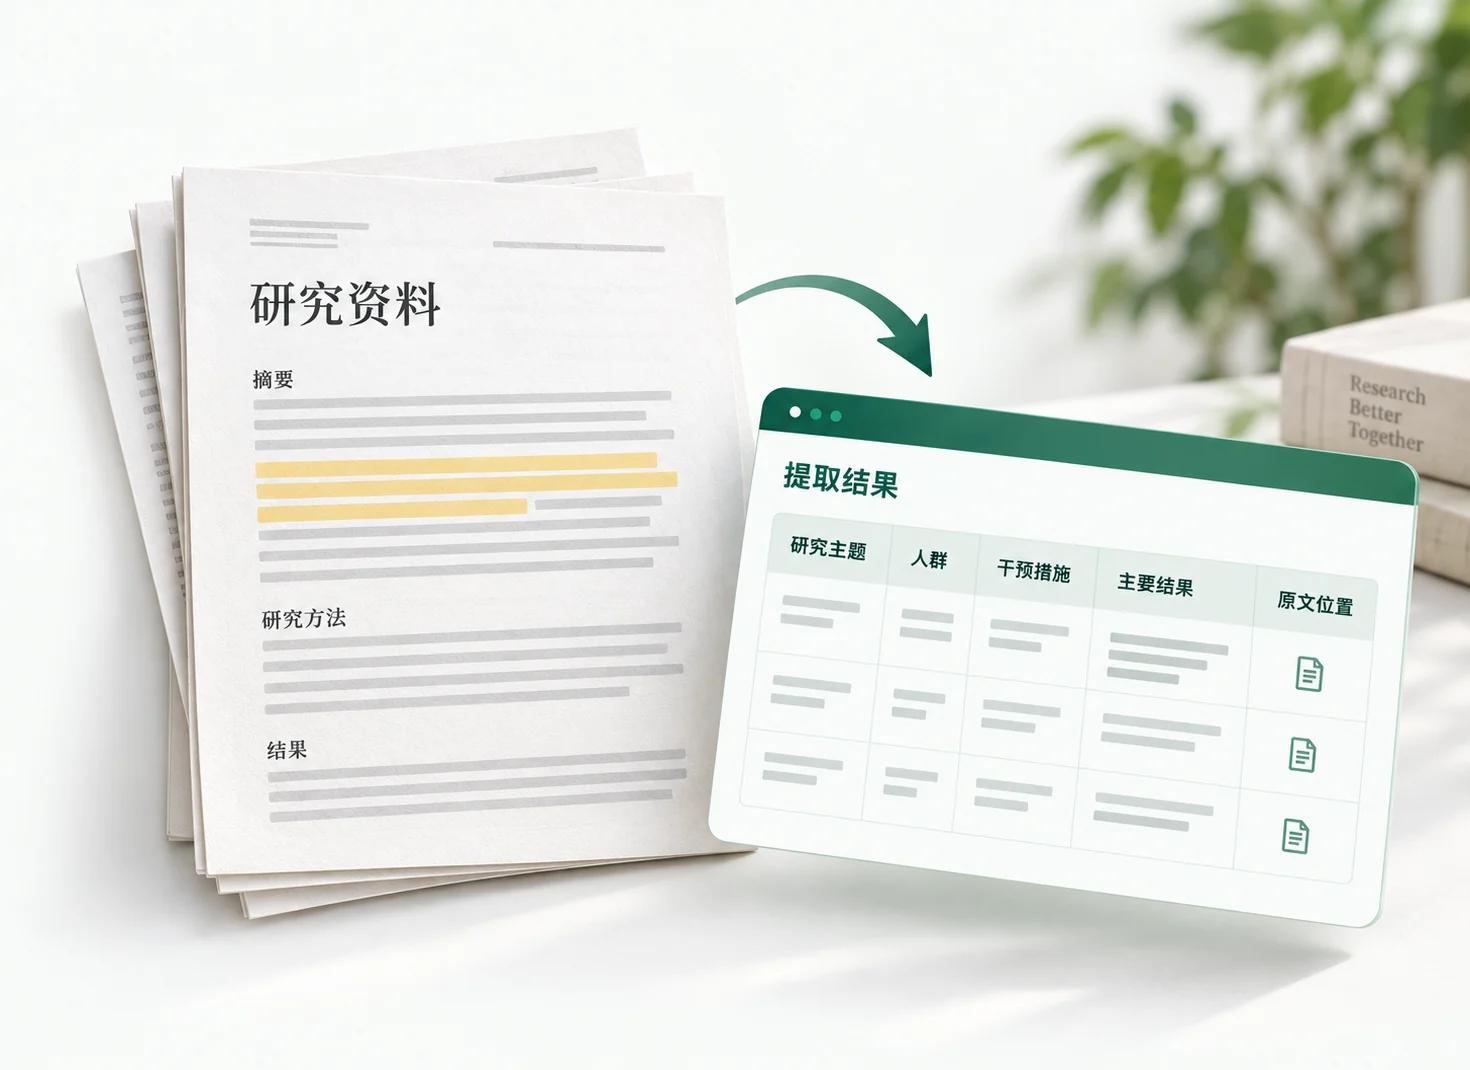
文献筛选
按研究标准筛选文献,
有序管理纳入与排除。
按研究标准筛选文献,
有序管理纳入与排除。
按自定义字段与回复样板,
从文献中整理所需信息。
回溯原文,在线核对,
记录团队每次修改与确认。
模型候选辅助提取,重要结论请核对原文。
每列可读取主文献、按设置选用的附件,或仅读取指定来源列的结果。仅使用列结果的列不会直接读取 PDF;如果需要补跑上游,上游仍按自身来源设置读取材料。
PDF / Word 先解析文字;文本和上传图片按支持的输入方式处理。文字解析不代表已理解 PDF 内嵌图表,复杂图表请补充图片并核对原文。
文献提取由 A、B、C 三路独立生成候选,各路不互看结果;仅使用指定列结果时采用两路独立候选。具体模型与参数以 API 设置及列设置为准。
程序按一致性与证据规则核对,存在分歧或证据不足时需人工处理。模型一致不等于结论正确,也不等于人工确认。
文献之间可并行处理,当前每批最多 50 篇。只有明确引用字段才形成依赖,列的左右位置不代表上下游。可用来源结果会复用,需要补跑时按依赖顺序处理。
服务端并发上限和模型厂商限流会影响耗时。运行使用真实 API,提取、文件解析及重试可能产生费用,请关注账户余额。
点击单元格的重新提取按钮,会直接按当前已保存的列设置运行,不再弹出确认窗口。批量运行仍需确认,默认跳过人工已确认的单元格。主动重新提取某个单元格,或取消跳过选项后,新 AI 结果会替换当前展示值;原确认值与操作记录保留在审计记录中。
重新生成的结果不继承人工确认。请对照原文检查,再保存需要的核对结果。